
Falaaaaaa, Guerreiros.
Recentemente fui contratado para resolver um problema que parece simples até você colocar a mão no banco:
“Precisamos extrair os dados de um banco Firebird, mas não temos a senha.”
O objetivo era relativamente direto:
- acessar o banco;
- entender sua estrutura;
- identificar tabelas e relacionamentos;
- extrair os dados;
- migrar para um novo banco PostgreSQL;
- preservar as informações e, principalmente, a integridade dos relacionamentos.
Na prática?
Foi um trabalho cansativo e bastante manual.
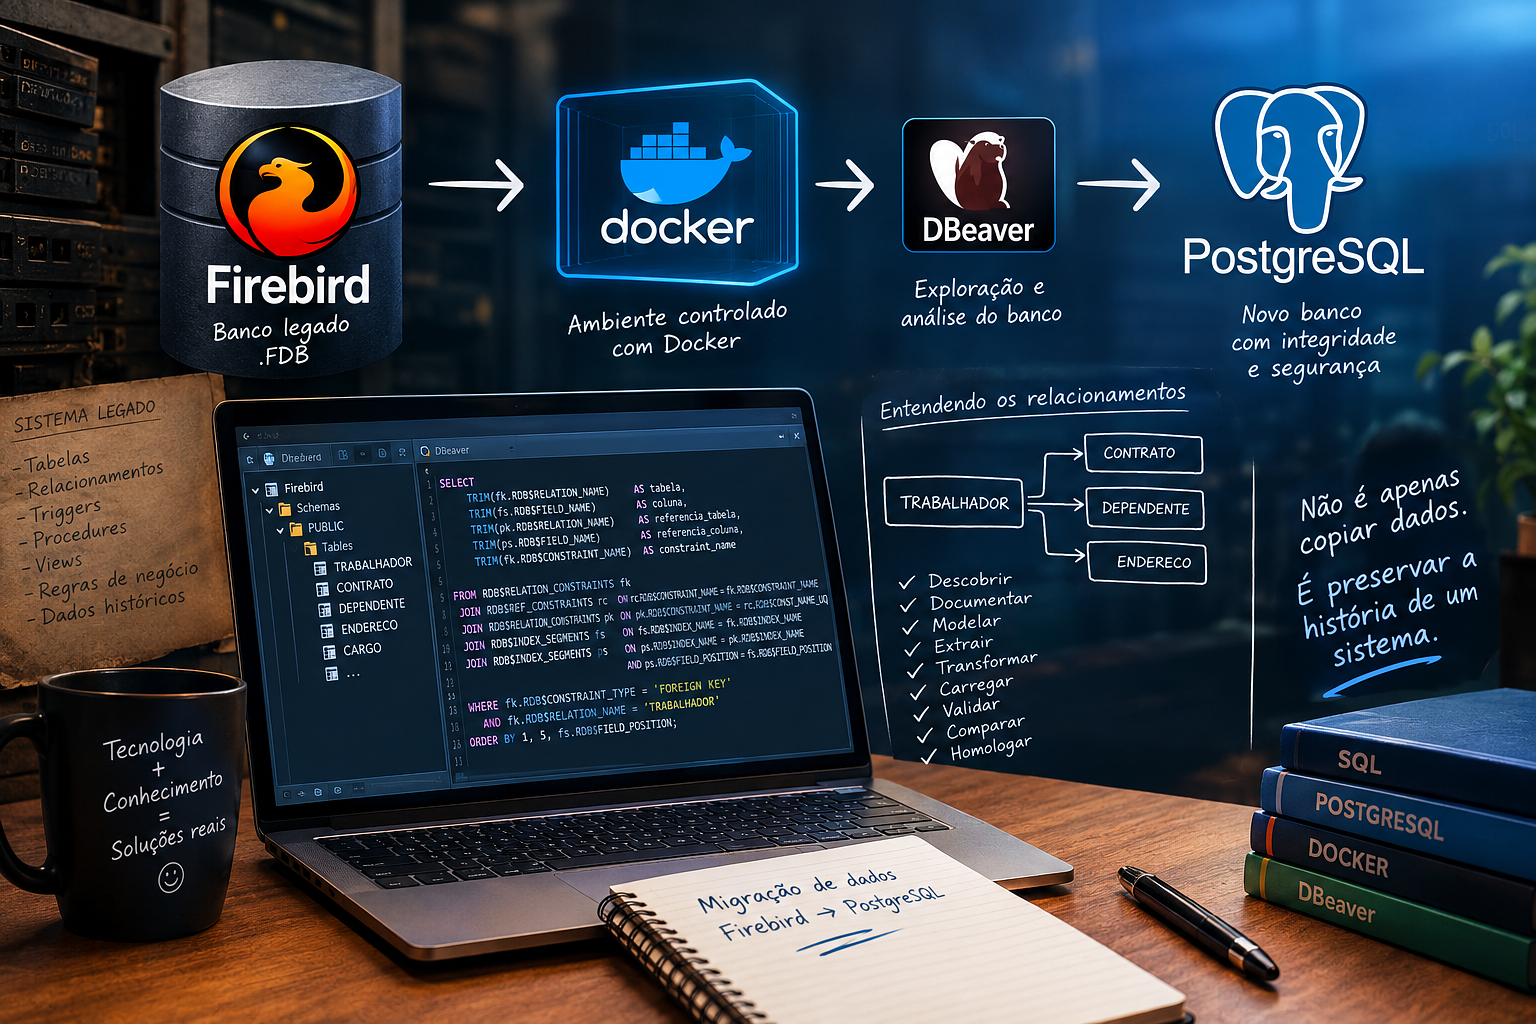
E foi justamente aí que surgiu uma experiência interessante envolvendo Docker, Firebird, DBeaver e PostgreSQL.
Primeiro: uma confusão muito comum
Quando alguém encontra um sistema legado Firebird, normalmente aparecem nomes de usuários como:
SYSDBA
SYSADM
SYSADMIN
ADMIN
Mas esses nomes não significam a mesma coisa.
No Firebird, SYSDBA é uma conta administrativa do servidor.
Já usuários como:
SYSADM
SYSADMIN
podem simplesmente ser usuários criados pela própria aplicação.
Ou seja:
não existe uma “senha padrão universal”, de um ERP ou de qualquer outro sistema que permita acessar todos os bancos, existem alguns ( kkkkkk ), de empresas enormes mais não é o caso, será?.
Isso é importante.
Em um processo autorizado de migração, o caminho correto é obter acesso administrativo ao ambiente Firebird ou receber credenciais apropriadas do responsável pelo sistema.
A partir daí podemos criar um usuário técnico específico para a migração.
Por exemplo:
docker exec firebird \
  /usr/local/firebird/bin/gsec \
  -user SYSDBA \
  -password senhaQueVcDesejar \
  -add LEITURA \
  -pw leitura
Ou:
docker exec firebird \
  /usr/local/firebird/bin/gsec \
  -user SYSDBA \
  -password senhaQueVcDesejar \
  -add FSCDB \
  -pw fscdb
Nesse cenário, podemos separar as responsabilidades:
LEITURA  → usuário utilizado para consultas
FSCDB    → usuário com permissões de leitura e escrita
O importante é entender que isso só funciona porque estamos administrando o ambiente Firebird. Não é uma técnica para descobrir ou quebrar a senha de um banco de terceiros.
Colocando o Firebird dentro do Docker
Uma das coisas que facilitaram bastante o trabalho foi colocar o Firebird em um container.
Um exemplo de docker-compose.yml utilizado nesse tipo de ambiente:
services:

  firebird:

    image: jacobalberty/firebird:2.5-ss

    platform: linux/amd64

    container_name: firebird

    ports:
      - "127.0.0.1:3050:3050"

    environment:
      ISC_PASSWORD: ${FIREBIRD_PASSWORD:-senhaQueVcDesejar}

    volumes:
      - ./db/exp:/firebird/data
      - ./tmp/firebird:/firebird/uploads
      - fbsystem:/firebird/system

volumes:

  fbsystem:
Aqui temos três pontos interessantes.
Banco
- ./db/exp:/firebird/data
O diretório local contém os arquivos .FDB.
Assim o banco permanece fora do container e podemos trabalhar com ele de maneira controlada.
Sistema do Firebird
- fbsystem:/firebird/system
Esse volume é importante porque mantém os dados do ambiente Firebird entre reinicializações do container.
Porta
- "127.0.0.1:3050:3050"
A porta padrão do Firebird é:
3050
E, nesse exemplo, ela fica disponível somente localmente.
Conectando pelo DBeaver
Com o container funcionando:
docker compose up -d
Podemos verificar:
docker ps
Depois utilizamos o DBeaver para acessar o Firebird.
Uma URL JDBC pode ser semelhante a:
jdbc:firebirdsql://localhost:3050//firebird/data/DB.FDB
A estrutura é:
jdbc:firebirdsql://HOST:PORT/CAMINHO_DO_BANCO
Nesse caso:
HOST       = localhost
PORT       = 3050
DATABASE   = /firebird/data/DB.FDB
O problema real começa depois da conexão
Conseguir conectar é apenas o começo.
Em uma migração, não basta copiar:
Tabela A
Tabela B
Tabela C
Precisamos descobrir como essas tabelas se relacionam.
Imagine:
TRABALHADOR
     |
     +---- DEPENDENTE
     |
     +---- ENDERECO
     |
     +---- CONTRATO
Se simplesmente exportarmos os dados sem compreender essas relações, podemos acabar com um banco PostgreSQL contendo os dados, mas sem preservar corretamente sua estrutura.
E aqui entra uma das partes interessantes do Firebird.
Consultando as Foreign Keys
O Firebird possui suas próprias tabelas de sistema.
Entre elas encontramos informações sobre:
RDB$RELATION_CONSTRAINTS
RDB$REF_CONSTRAINTS
RDB$INDEX_SEGMENTS
Podemos consultar essas estruturas para descobrir os relacionamentos.
Por exemplo:
SELECT
    TRIM(fk.RDB$RELATION_NAME)   AS tabela,
    TRIM(fs.RDB$FIELD_NAME)      AS coluna,
    TRIM(pk.RDB$RELATION_NAME)   AS referencia_tabela,
    TRIM(ps.RDB$FIELD_NAME)      AS referencia_coluna,
    TRIM(fk.RDB$CONSTRAINT_NAME) AS constraint_name

FROM RDB$RELATION_CONSTRAINTS fk

JOIN RDB$REF_CONSTRAINTS rc
    ON rc.RDB$CONSTRAINT_NAME = fk.RDB$CONSTRAINT_NAME

JOIN RDB$RELATION_CONSTRAINTS pk
    ON pk.RDB$CONSTRAINT_NAME = rc.RDB$CONST_NAME_UQ

JOIN RDB$INDEX_SEGMENTS fs
    ON fs.RDB$INDEX_NAME = fk.RDB$INDEX_NAME

JOIN RDB$INDEX_SEGMENTS ps
    ON ps.RDB$INDEX_NAME = pk.RDB$INDEX_NAME
    AND ps.RDB$FIELD_POSITION = fs.RDB$FIELD_POSITION

WHERE fk.RDB$CONSTRAINT_TYPE = 'FOREIGN KEY'

  AND fk.RDB$RELATION_NAME = 'TRABALHADOR'

ORDER BY
    1,
    5,
    fs.RDB$FIELD_POSITION;
O resultado pode nos mostrar algo semelhante a:
tabela       coluna          referencia_tabela   referencia_coluna
-----------------------------------------------------------------
DEPENDENTE   ID_TRABALHADOR  TRABALHADOR         ID
CONTRATO     ID_TRABALHADOR  TRABALHADOR         ID
ENDERECO     ID_TRABALHADOR  TRABALHADOR         ID
Agora começamos a enxergar o grafo de dependências do banco.
E isso é muito mais importante do que simplesmente listar as tabelas.
Por que isso importa na migração?
Imagine que temos:
TRABALHADOR
CONTRATO
DEPENDENTE
ENDERECO
Se CONTRATO.ID_TRABALHADOR referencia:
TRABALHADOR.ID
não podemos tratar as tabelas como estruturas independentes.
Existe uma ordem lógica de migração.
Primeiro:
TRABALHADOR
Depois:
CONTRATO
DEPENDENTE
ENDERECO
Ou, dependendo da estratégia adotada, podemos desabilitar temporariamente determinadas constraints durante a carga e validá-las posteriormente.
O importante é que a integridade referencial seja verificada, e não simplesmente ignorada.
Firebird → PostgreSQL
Foi aí que a migração começou a ficar realmente interessante.
O fluxo passou a ser:
                 Firebird
                    │
                    ▼
              Docker
                    │
                    ▼
                DBeaver
                    │
           ┌────────┴────────┐
           │                 │
           ▼                 ▼
      Estrutura           Dados
           │                 │
           └────────┬────────┘
                    ▼
                PostgreSQL
Mas migrar banco não significa apenas fazer:
SELECT *
e jogar o resultado no PostgreSQL.
Precisamos considerar:
- tipos de dados;
- chaves primárias;
- chaves estrangeiras;
- índices;
- constraints;
- campos obrigatórios;
- valores nulos;
- sequences/generators;
- datas;
- campos numéricos;
- caracteres;
- encoding;
- triggers;
- procedures;
- views;
- regras de negócio;
- dependências entre tabelas.
E existe outro detalhe importante:
o banco de dados não é apenas um conjunto de tabelas.
Ele contém parte da lógica e das regras do sistema.
O verdadeiro desafio
Na minha experiência, a parte mais trabalhosa não foi conectar o Firebird.
Foi entender o que estava dentro dele.
Um banco legado pode ter:
200 tabelas
500 tabelas
1000 tabelas
e ainda possuir:
tabelas sem documentação
nomes pouco intuitivos
campos antigos
triggers
procedures
relacionamentos
regras implícitas
dados históricos
Você precisa praticamente fazer engenharia reversa do sistema.
E é aí que ferramentas como DBeaver ajudam bastante.
Mas ferramenta nenhuma substitui a análise.
Uma coisa que aprendi com esse tipo de projeto
Quando alguém fala:
“É só migrar o banco.”
Eu já sei que provavelmente não é.
Migrar banco é uma coisa.
Migrar informação preservando significado e integridade é outra.
É possível copiar milhões de registros rapidamente.
O problema é descobrir se, depois da cópia:
1 registro continua sendo 1 registro?

as chaves continuam corretas?

os relacionamentos continuam válidos?

as datas continuam representando a mesma coisa?

os valores possuem a mesma precisão?

as regras de negócio continuam funcionando?

os relatórios continuam apresentando os mesmos resultados?
Essa é a diferença entre copiar dados e migrar um sistema.
E o PostgreSQL?
Depois que a estrutura foi compreendida, o PostgreSQL entra como o destino.
Mas eu prefiro pensar na migração em etapas:
1. Descobrir
2. Documentar
3. Modelar
4. Extrair
5. Transformar
6. Carregar
7. Validar
8. Comparar
9. Homologar
Somente depois disso podemos dizer:
“A migração terminou.”
Porque quantidade de registros igual não significa necessariamente que a migração está correta.
Conclusão
Uma das coisas mais interessantes da tecnologia é que problemas que parecem simples geralmente escondem uma quantidade enorme de conhecimento.
Nesse caso, o problema começou com:
“Precisamos pegar os dados de um Firebird.”
E terminou envolvendo:
Firebird
Docker
DBeaver
SQL
engenharia reversa
integridade referencial
migração de dados
PostgreSQL
E talvez essa seja uma das maiores lições de trabalhar com sistemas legados:
o banco de dados pode ser antigo, mas os problemas que ele apresenta continuam extremamente atuais.
E quando você precisa migrar milhões de informações sem perder o significado delas, não está simplesmente copiando dados.
Está preservando a história daquele sistema.