
Falaaaaa, Guerreiros.
Nos últimos tempos, quatro termos começaram a aparecer praticamente em toda conversa sobre Inteligência Artificial:
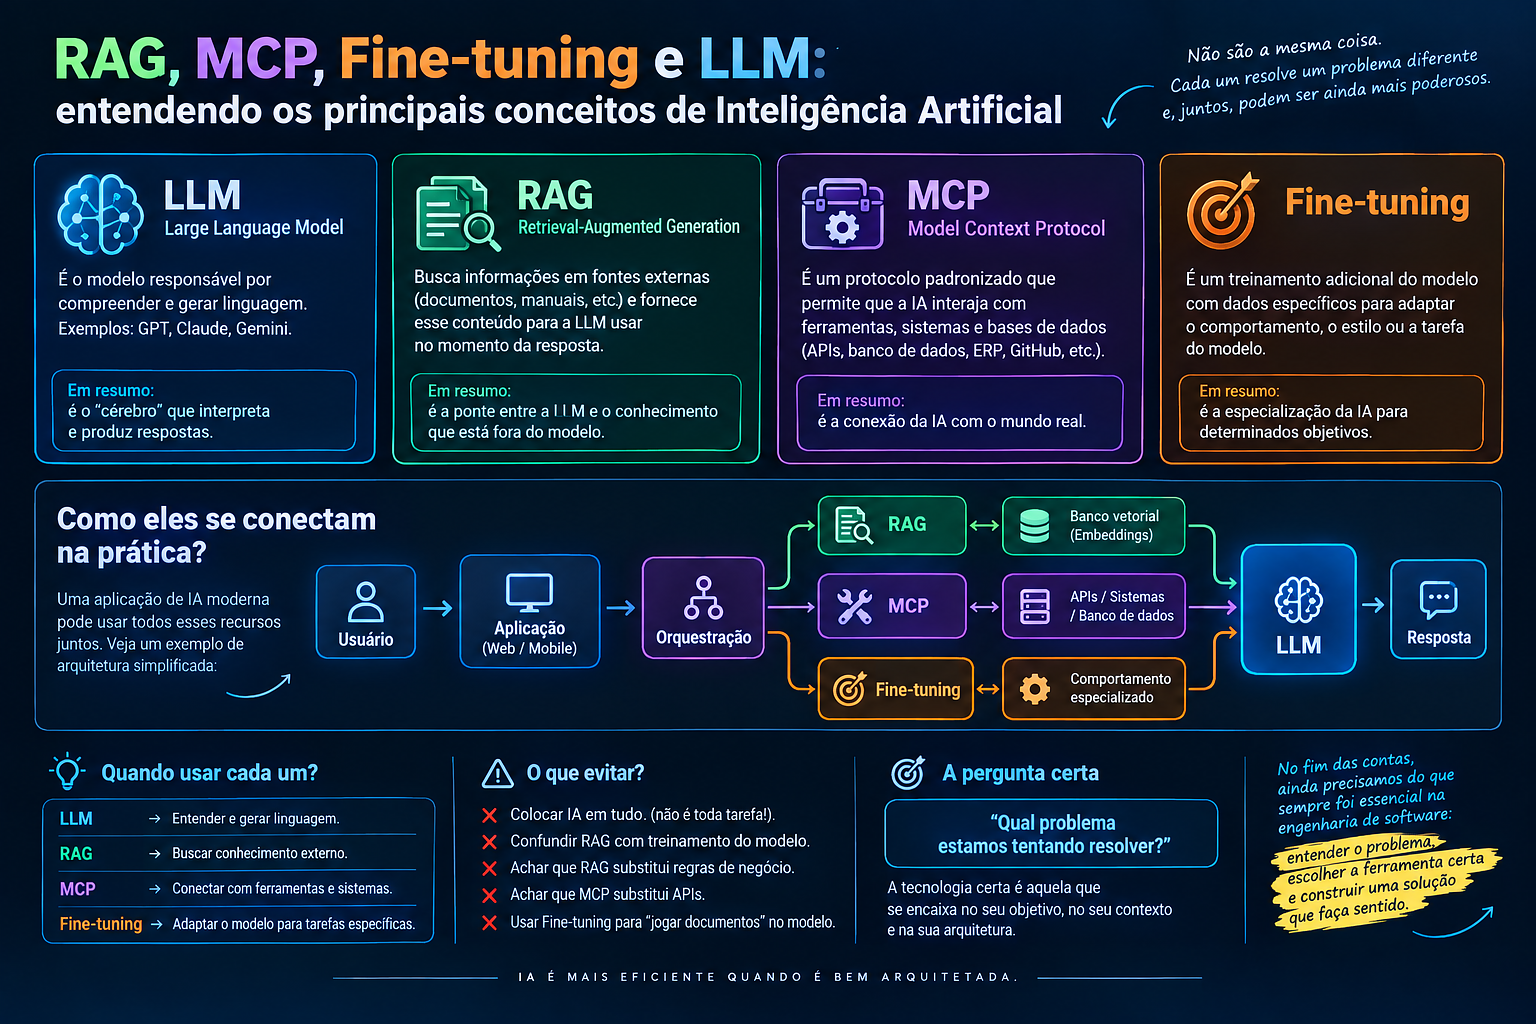
LLM, RAG, MCP e Fine-tuning.
É comum encontrar pessoas falando desses conceitos como se fossem tecnologias concorrentes ou como se um substituísse o outro.
Não é bem assim.
Eles resolvem problemas diferentes e, em muitos projetos, podem inclusive trabalhar juntos.
Para entender isso de forma simples, imagine que estamos construindo um sistema de IA para uma empresa.
A empresa possui milhares de documentos, um banco de dados, APIs, regras internas e processos específicos.
Como fazemos a IA trabalhar com tudo isso?
É aí que entram esses conceitos.
1. Primeiro: o que é uma LLM?
LLM significa Large Language Model, ou Modelo de Linguagem de Grande Escala.
É o modelo responsável por compreender e gerar linguagem.
Modelos como GPT, Claude, Gemini e outros são exemplos de modelos que podem trabalhar com linguagem natural.
De forma simplificada:
A LLM é o modelo que recebe informações e produz uma resposta.
Por exemplo:
Usuário:
Explique o que é uma nota fiscal eletrônica.

LLM:
Uma nota fiscal eletrônica é um documento...
Mas existe uma questão importante.
A LLM não necessariamente conhece os dados privados da sua empresa.
Imagine que você pergunte:
Qual foi o faturamento da empresa em setembro?
A LLM não tem como simplesmente "adivinhar" essa informação.
Ela precisa receber esse dado de algum lugar.
E é aqui que começamos a entrar em outros conceitos.
2. RAG — Retrieval-Augmented Generation
RAG significa:
Retrieval-Augmented Generation
Em português, podemos entender como:
Geração Aumentada por Recuperação de Informação.
O conceito é relativamente simples:
Antes de pedir para a LLM responder, buscamos informações relevantes em uma fonte externa e entregamos essas informações para ela.
Imagine uma empresa que possui:
contratos/
    contrato_001.pdf
    contrato_002.pdf

manuais/
    manual_vendas.pdf
    manual_financeiro.pdf

documentacao/
    regras_fiscais.pdf
    politica_comercial.pdf
Em vez de treinar novamente o modelo com todos esses documentos, podemos criar um sistema RAG.
O fluxo seria aproximadamente:
Usuário
   ↓
Pergunta
   ↓
Sistema de busca
   ↓
Documentos relevantes
   ↓
Contexto
   ↓
LLM
   ↓
Resposta
Por exemplo:
Usuário:
Qual é o prazo para cancelamento previsto no contrato?

RAG:
Encontra o trecho relevante do contrato.

LLM:
Utiliza aquele trecho para construir a resposta.
E aqui existe uma diferença fundamental:
RAG não significa treinar a IA.
Os documentos continuam fora do modelo.
Eles são recuperados no momento da pergunta.
Como o RAG normalmente funciona?
Uma arquitetura simplificada pode ser:
Documentos
    ↓
Extração de texto
    ↓
Quebra em pequenos trechos
    ↓
Embeddings
    ↓
Banco vetorial
Quando o usuário faz uma pergunta:
Pergunta
   ↓
Embedding da pergunta
   ↓
Busca semântica
   ↓
Trechos relevantes
   ↓
LLM
   ↓
Resposta
É possível utilizar tecnologias como:
- PostgreSQL + pgvector
- Redis
- Elasticsearch
- OpenSearch
- Pinecone
- Qdrant
- Weaviate
Portanto, RAG é muito interessante quando precisamos fazer a IA trabalhar com informações que estão fora do modelo.
3. MCP — Model Context Protocol
Agora vamos para o MCP.
MCP significa:
Model Context Protocol.
Aqui a ideia é diferente.
Enquanto o RAG está muito relacionado à recuperação de informações, o MCP estabelece uma forma padronizada para um modelo de IA interagir com ferramentas, sistemas e fontes de dados.
Imagine que temos uma IA e queremos permitir que ela consulte:
Banco de dados
API
GitHub
Sistema financeiro
Sistema de estoque
CRM
Filesystem
Uma abordagem tradicional poderia exigir uma integração específica para cada sistema.
O MCP propõe um protocolo padronizado para conectar modelos de IA a essas ferramentas.
Uma representação simplificada:
                 ┌───────────────┐
                 │      LLM      │
                 └───────┬───────┘
                         │
                        MCP
                         │
        ┌────────────────┼────────────────┐
        ↓                ↓                ↓
    Banco de dados      API             GitHub
Assim, a IA pode ter acesso a ferramentas que foram disponibilizadas para ela.
Por exemplo:
Ferramenta:
consultar_cliente

Entrada:
CPF = 000.000.000-00

Resultado:
Cliente encontrado.
Ou:
Ferramenta:
consultar_estoque

Entrada:
produto = 12345

Resultado:
Estoque disponível = 42
A IA não precisa necessariamente conhecer internamente como aquela ferramenta foi implementada.
Ela recebe uma interface que permite utilizá-la.
4. RAG e MCP não são a mesma coisa
Essa é uma das confusões mais comuns.
Imagine um sistema de vendas.
RAG
Queremos responder:
"Qual é a política da empresa para devolução?"
O sistema procura nos documentos:
politica_devolucao.pdf
manual_cliente.pdf
E fornece os trechos relevantes para a LLM.
Isso é RAG.
MCP
Agora o usuário pergunta:
"Qual é o pedido #12345 e qual é o status da entrega?"
Nesse caso, precisamos consultar um sistema externo.
Podemos disponibilizar uma ferramenta:
consultar_pedido(12345)
A IA chama a ferramenta e recebe o resultado.
Isso é uma utilização típica de MCP.
5. Fine-tuning — quando queremos adaptar o modelo
Agora chegamos ao Fine-tuning.
Fine-tuning significa realizar um treinamento adicional de um modelo já existente utilizando um conjunto específico de exemplos.
A ideia não é simplesmente fornecer documentos para consulta.
Aqui queremos adaptar o comportamento do modelo.
Imagine uma empresa que possui milhares de exemplos de atendimento:
Pergunta do cliente
        ↓
Resposta esperada
Podemos utilizar esses exemplos para ajustar o modelo para determinado padrão.
Por exemplo:
Cliente:
Meu pedido atrasou.

Resposta desejada:
Olá! Vamos verificar o status do seu pedido...
Depois de um processo de fine-tuning, o modelo pode ficar melhor adaptado àquele padrão de resposta.
6. Fine-tuning não é simplesmente "ensinar documentos"
Essa distinção é extremamente importante.
Imagine que uma empresa possui:
10.000 contratos
E alguém diz:
"Vamos fazer fine-tuning com esses contratos para a IA aprender."
Talvez essa não seja a melhor solução.
Se o objetivo é simplesmente permitir que a IA consulte o conteúdo dos contratos, RAG pode ser muito mais apropriado.
Fine-tuning é mais interessante quando queremos alterar ou especializar aspectos do comportamento do modelo.
Por exemplo:
Estilo de resposta
Formato de saída
Classificação
Comportamento específico
Tarefa especializada
Padrão de interação
Enquanto o RAG responde melhor à pergunta:
"Onde está a informação?"
O Fine-tuning está mais relacionado a:
"Como quero que o modelo se comporte para determinada tarefa?"
7. Colocando tudo junto
Agora podemos visualizar melhor a diferença.
Imagine um ERP com um assistente de IA.
O usuário pergunta:
"Analise o cliente João, veja os últimos pedidos, consulte nossa política de crédito e diga se podemos liberar uma nova compra."
Temos vários problemas diferentes nessa pergunta.
LLM
Interpreta a pergunta e gera a resposta.
RAG
Pode consultar:
Política de crédito
Manual comercial
Documentação interna
Procedimentos da empresa
MCP
Pode disponibilizar ferramentas para:
consultar_cliente()
consultar_pedidos()
consultar_limite_credito()
consultar_estoque()
Fine-tuning
Pode ser utilizado caso queiramos adaptar o modelo para uma tarefa específica, por exemplo, classificar clientes de acordo com um padrão próprio ou produzir respostas seguindo determinado formato.
Podemos imaginar a arquitetura:
                         USUÁRIO
                            │
                            ↓
                     ┌─────────────┐
                     │     LLM     │
                     └──────┬──────┘
                            │
             ┌──────────────┼──────────────┐
             ↓              ↓              ↓
            RAG            MCP        Fine-tuning
             │              │              │
             ↓              ↓              ↓
        Documentos       Ferramentas    Comportamento
             │              │
             ↓              ↓
       Banco vetorial    APIs / DB / ERP
8. Uma analogia simples
Podemos pensar em um profissional.
LLM = cérebro
É responsável por interpretar e produzir respostas.
RAG = biblioteca
Permite consultar informações externas.
MCP = ferramentas e acessos
Permite utilizar sistemas e executar determinadas ações.
Fine-tuning = especialização
Ajuda a adaptar o profissional para uma determinada função.
Imagine um médico.
Ele possui conhecimento geral.
Isso seria semelhante à capacidade geral da LLM.
Agora ele consulta o prontuário do paciente.
Isso lembra o RAG.
Ele utiliza sistemas do hospital para consultar exames e informações.
Isso lembra uma integração via ferramentas, como MCP.
E ele possui uma formação especializada em determinada área.
Isso ajuda a representar a ideia de especialização por treinamento.
9. E onde entra o banco de dados?
Aqui começa uma parte ainda mais interessante para quem desenvolve sistemas.
Não precisamos transformar tudo em vetor.
Imagine:
SELECT *
FROM pedidos
WHERE cliente_id = 123;
Se precisamos de um dado estruturado e exato, um banco relacional continua sendo extremamente eficiente.
Por exemplo:
Qual foi o faturamento do cliente 123 em setembro?
Talvez seja melhor executar uma consulta SQL do que procurar essa informação em embeddings.
Já para:
Quais são as regras da empresa para clientes inadimplentes?
Um mecanismo de busca semântica pode ser muito útil.
Por isso, uma arquitetura moderna pode combinar:
PostgreSQL
Redis
RAG
MCP
APIs
LLM
Cada tecnologia resolve um problema diferente.
10. O erro de colocar IA em tudo
Existe uma tendência de transformar qualquer problema em:
"Vamos colocar uma LLM."
Mas isso pode ser um erro arquitetural.
Se precisamos calcular:
100 + 200
não precisamos de uma LLM.
Se precisamos buscar:
SELECT * FROM clientes WHERE id = 10;
não precisamos necessariamente de RAG.
Se precisamos executar:
calcular_total_pedido()
uma função tradicional pode ser suficiente.
IA deve entrar onde ela realmente agrega valor.
11. A arquitetura é mais importante que o hype
Uma aplicação de IA profissional não é simplesmente:
Usuário → LLM → Resposta
Em muitos casos teremos algo muito mais próximo de:
                    Usuário
                       │
                       ↓
                 Aplicação Web
                       │
                       ↓
                  Orquestração
                       │
          ┌────────────┼─────────────┐
          ↓            ↓             ↓
        RAG           MCP        Regras de negócio
          │            │
          ↓            ↓
    Banco vetorial   APIs / DB
          │            │
          └──────┬─────┘
                 ↓
                LLM
                 │
                 ↓
              Resposta
E dependendo do problema, podemos adicionar Fine-tuning.
12. Então, qual usar?
Podemos resumir assim:
| Tecnologia | Principal objetivo |
|---|---|
| LLM | Entender e gerar linguagem |
| RAG | Buscar conhecimento externo |
| MCP | Conectar a IA com ferramentas e sistemas |
| Fine-tuning | Adaptar o modelo para tarefas/comportamentos específicos |
E uma aplicação pode utilizar todos eles ao mesmo tempo.
Por exemplo:
LLM
 ├── RAG → consulta documentos
 ├── MCP → consulta ERP
 ├── MCP → consulta banco/API
 └── Fine-tuning → comportamento especializado
Conclusão
A grande questão não é:
"Qual dessas tecnologias é melhor?"
A pergunta correta é:
"Qual problema estamos tentando resolver?"
Se precisamos de conhecimento externo, podemos pensar em RAG.
Se precisamos conectar a IA a ferramentas e sistemas, podemos pensar em MCP.
Se precisamos adaptar o comportamento do modelo para uma tarefa específica, podemos avaliar Fine-tuning.
E no centro de tudo isso pode estar uma LLM, responsável por interpretar o contexto e produzir a resposta.
O mais importante, principalmente para quem desenvolve software, é não confundir IA com arquitetura.
Uma LLM não substitui banco de dados.
RAG não substitui regras de negócio.
MCP não substitui APIs.
Fine-tuning não é simplesmente "jogar documentos dentro da IA".
E IA nenhuma elimina a necessidade de entender o problema que estamos tentando resolver.
No final das contas, continuamos precisando daquilo que sempre foi necessário na engenharia de software:
entender o problema, escolher a ferramenta adequada e construir uma arquitetura que faça sentido.
A diferença é que agora temos novas ferramentas para colocar na nossa caixa de ferramentas.