Fala, Guerreiros e Guerreiras!
Nesta manhã quente, ao som da melhor banda de Thrash Metal do mundo — o SLAYER — ouvindo Show No Mercy, o melhor álbum do mundo, na minha opinião, vamos falar de um assunto que está transformando a forma como trabalhamos, pesquisamos e produzimos conhecimento.
Quero compartilhar algumas reflexões relacionadas ao meu projeto de mestrado, que investiga uma questão cada vez mais relevante: o uso da Inteligência Artificial sem o devido exercício do pensamento crítico humano.
O título é provocativo de propósito. Afinal, como podemos falar em inteligência artificial sem discutir a inteligência humana e a nossa capacidade de pensar?
Não estou aqui para afirmar que a IA não funciona, que seus avanços são irrelevantes ou que tudo o que ela produz é falso. Muito pelo contrário. Estamos diante de ferramentas capazes de transformar o desenvolvimento de software, a pesquisa, a análise documental e diversas atividades profissionais.
O problema começa quando confundimos a capacidade de produzir uma resposta com a garantia de que ela está correta.
E fica ainda mais sério quando deixamos de questionar o resultado simplesmente porque ele parece coerente, tecnicamente sofisticado e profissionalmente convincente.
Uma resposta bem escrita não é necessariamente verdadeira. Um código que compila não é necessariamente seguro. Uma decisão encontrada em uma pesquisa não é necessariamente aplicável ao caso analisado.
É sobre essa relação entre tecnologia, confiança e responsabilidade humana que quero refletir.
1. A Skynet não precisa existir para discutirmos os riscos da IA
Quando criança, assisti aos filmes da franquia O Exterminador do Futuro. No primeiro, acompanhamos Sarah Connor em uma história marcada pela tentativa de alterar um futuro catastrófico. No segundo, a Skynet ganha ainda mais protagonismo como representação de uma tecnologia que se transforma em ameaça à humanidade.
É ficção, claro. Não precisamos acreditar que os sistemas atuais possuem consciência, sentimentos ou vontade própria para reconhecer que a automação pode produzir consequências graves.
A Skynet serve como provocação, não como previsão tecnológica.
A pergunta que me interessa é muito mais próxima da nossa realidade: o que acontece quando construímos sistemas capazes de executar operações complexas e delegamos tarefas a eles sem compreender adequadamente seus limites?
Não precisamos de robôs de guerra para discutir o problema. Basta observar o crescimento dos modelos de linguagem, a integração de agentes de IA a sistemas empresariais e a possibilidade de ferramentas automatizadas consultarem serviços, modificarem arquivos e executarem operações em ambientes reais.
O risco não depende de uma máquina desenvolver consciência. Pode surgir de uma arquitetura mal configurada, de permissões excessivas, de dados incorretos ou de uma pessoa que confia em um resultado sem verificar as premissas que o sustentam.
A questão não é se estamos construindo a Skynet. É se estamos desenvolvendo sistemas cada vez mais capazes sem evoluir, na mesma proporção, os mecanismos de controle, validação e responsabilidade.
2. Quando a automação deixa de ser apenas uma ferramenta
Vamos voltar às origens da engenharia de software.
Em um programa tradicional, podemos definir uma condição e estabelecer explicitamente o comportamento esperado:
if idade >= 18
  puts "Maior de idade"
else
  puts "Menor de idade"
end
O exemplo é simples. O comportamento depende de uma condição escrita pelo desenvolvedor. Sabemos qual regra está sendo avaliada e quais saídas foram programadas.
Podemos ampliar essa lógica com funções, estruturas condicionais, expressões regulares, consultas SQL, filas de processamento e integrações com outros serviços. Foi assim que construímos sistemas bancários, plataformas de comércio eletrônico, aplicações empresariais e serviços públicos.
Isso não significa que os sistemas tradicionais sejam infalíveis. Eles também apresentam falhas, dependem de dados corretos e podem conter regras de negócio equivocadas. A diferença está na natureza do mecanismo utilizado.
Com os modelos de linguagem, temos outra abordagem.
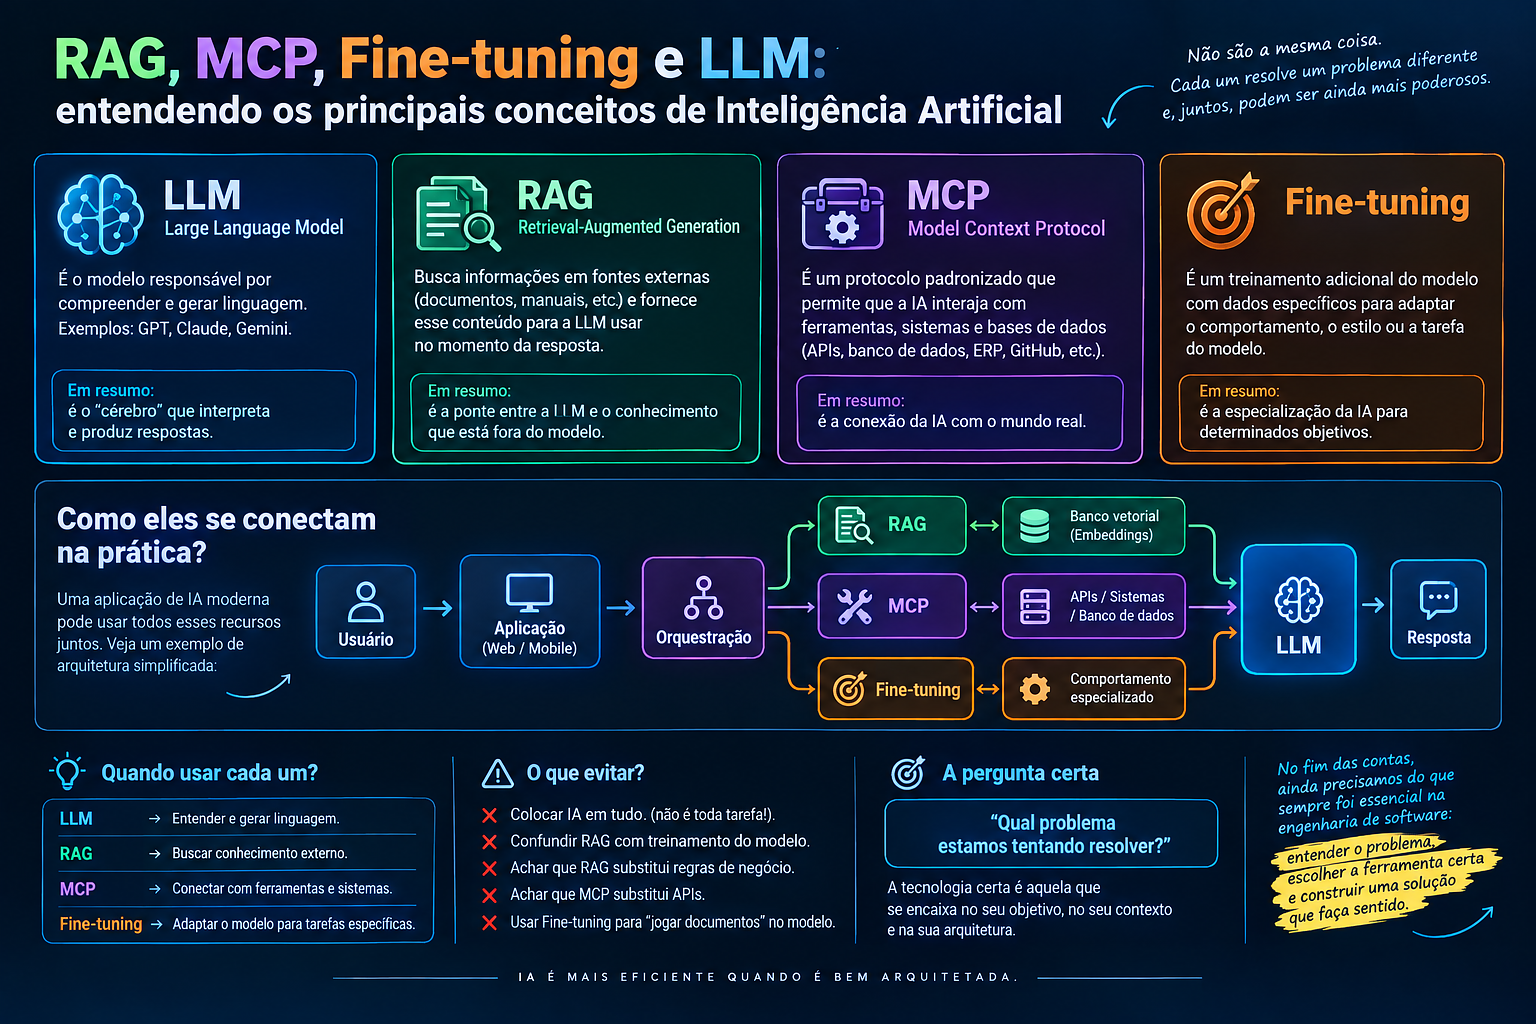
Uma LLM (Large Language Model) utiliza parâmetros aprendidos durante o treinamento para gerar respostas a partir de entradas e contextos. Seu comportamento não se resume a uma sequência de regras explícitas escritas pelo desenvolvedor.
Quando integramos um modelo a ferramentas externas e a mecanismos de orquestração, podemos construir agentes capazes de selecionar ações, consultar fontes, avaliar resultados e solicitar novas operações.
Isso amplia as possibilidades de automação, mas também aumenta a complexidade do sistema.
O desenvolvedor deixa de se preocupar apenas com o código que escreveu. Precisa considerar as instruções fornecidas ao modelo, os dados recebidos, as ferramentas disponíveis, as permissões concedidas e as condições em que uma ação poderá ser executada.
A IA não elimina a engenharia de software. Ela acrescenta novas camadas de engenharia, avaliação e governança.
Quanto maior a capacidade de ação de um sistema, maior deve ser o rigor aplicado ao controle dessa capacidade.
3. Regex, Full-Text Search e LLM: cada tecnologia tem seu papel
Para entender o cenário atual, precisamos distinguir tecnologias que muitas vezes são colocadas no mesmo pacote durante o debate público.
3.1. Regex: encontrar padrões
Regex, abreviação de Regular Expression, permite descrever padrões que queremos localizar em uma sequência de caracteres.
Imagine que precisamos identificar um texto no formato de um número de processo judicial:
texto = "Processo 0001234-56.2024.8.18.0001"

padrao = /\d{7}-\d{2}\.\d{4}\.\d\.\d{2}\.\d{4}/

if texto.match?(padrao)
  puts "Padrão textual encontrado."
else
  puts "Padrão não encontrado."
end
A expressão verifica se existe uma sequência de caracteres compatível com o formato definido.
Mas atenção: encontrar um padrão não comprova que o processo existe, que seus dados são verdadeiros ou que ele é relevante para determinada análise. A expressão identifica uma estrutura textual; outras verificações continuam necessárias.
3.2. Full-Text Search: recuperar documentos
Imagine agora um banco de dados com milhares de documentos jurídicos. Podemos utilizar a pesquisa textual do PostgreSQL:
SELECT
    id,
    titulo
FROM documentos_juridicos
WHERE to_tsvector(
    'portuguese',
    coalesce(conteudo, '')
)
@@ plainto_tsquery(
    'portuguese',
    'responsabilidade civil'
);
A consulta procura documentos compatíveis com os termos informados, utilizando os recursos linguísticos do mecanismo de pesquisa.
Isso é extremamente útil para localizar informações em grandes acervos. Entretanto, encontrar um documento que menciona responsabilidade civil não significa compreender seus fundamentos, verificar a validade de seus argumentos ou identificar a interpretação jurídica mais adequada.
3.3. LLM: produzir respostas a partir do contexto
Uma LLM pode receber uma pergunta, analisar o contexto disponível e produzir uma explicação em linguagem natural. Pode resumir documentos, comparar argumentos, organizar informações e auxiliar na elaboração de análises.
Mas também pode produzir informações incorretas com aparência de certeza.
O NIST, instituto norte-americano de padrões e tecnologia, discute riscos da IA generativa, incluindo a produção de informações falsas ou equivocadas apresentadas de maneira convincente. Esse fenômeno é frequentemente chamado de alucinação ou, na terminologia utilizada pelo NIST, confabulação.
A diferença é importante. Uma consulta SQL que não encontra registros normalmente devolve um resultado vazio. Uma LLM, dependendo da tarefa e da implementação, pode produzir uma resposta aparentemente completa mesmo quando faltam informações essenciais.
Nenhuma dessas tecnologias é superior em todas as situações. Regex é apropriada para determinados padrões; Full-Text Search ajuda a recuperar documentos; LLMs são úteis para tarefas de linguagem e síntese.
O erro é exigir que uma tecnologia faça o trabalho de outra ou confiar em um resultado sem aplicar os controles adequados.
A pergunta correta não é apenas: “Qual ferramenta consegue realizar essa tarefa?”.
É também: “Como vou verificar se o resultado produzido por essa ferramenta é confiável?”
4. Fine-tuning: especializar um modelo não é garantir a verdade
Outro conceito importante é o fine-tuning, ou ajuste fino de um modelo.
Nem toda empresa precisa desenvolver um modelo de linguagem do zero. Esse processo pode exigir grandes volumes de dados, infraestrutura computacional especializada e investimentos consideráveis.
Uma alternativa é partir de um modelo previamente treinado e adaptá-lo a uma finalidade específica.
De maneira simplificada, o fine-tuning consiste em continuar o treinamento do modelo com dados selecionados para melhorar seu comportamento em determinadas tarefas. Técnicas como LoRA e QLoRA podem tornar esse processo mais eficiente ao reduzir a quantidade de parâmetros que precisam ser ajustados.
Imagine uma empresa que deseja desenvolver uma solução para o setor jurídico. Ela pode avaliar se o ajuste fino de um modelo existente melhora tarefas como classificação de documentos, extração de informações processuais ou geração de respostas em um formato padronizado.
Considere uma aplicação que precisa extrair de documentos:
- Número do processo.
- Tribunal responsável.
- Partes envolvidas.
- Tipo de ação.
- Pedidos apresentados.
- Dispositivos legais mencionados.
Uma LLM genérica talvez já execute essas tarefas com instruções bem elaboradas. O fine-tuning passa a fazer sentido quando existe uma necessidade específica e evidências de que o ajuste pode melhorar o desempenho em comparação com alternativas mais simples.
Para avaliar isso, precisamos de dados de qualidade, exemplos revisados e um conjunto de avaliação independente dos dados utilizados no treinamento.
Também é necessário testar documentos incompletos, informações contraditórias e situações que não apareçam com frequência nos exemplos.
Se o modelo apresentar bons resultados apenas nos documentos utilizados durante o treinamento, mas falhar diante de novos casos, teremos um problema de generalização. Ele pode ter aprendido padrões excessivamente específicos, sem desenvolver o comportamento esperado para situações diferentes.
E há outro risco: dados de treinamento incorretos ou enviesados podem reproduzir e reforçar erros.
Fine-tuning não é RAG
Essa distinção é fundamental.
O fine-tuning adapta o comportamento do modelo por meio de treinamento adicional. O RAG (Retrieval-Augmented Generation) recupera informações externas durante a consulta e as fornece como contexto para a geração da resposta.
Imagine que uma lei tenha sido alterada recentemente. Um modelo ajustado com documentos antigos não passa automaticamente a conhecer a nova redação. Para trabalhar com informações atualizadas, a aplicação precisa consultar fontes adequadas e verificar a vigência do conteúdo.
Por outro lado, se a necessidade é melhorar a classificação de documentos ou a consistência de uma saída estruturada, o fine-tuning pode ser uma alternativa a avaliar.
As técnicas também podem ser combinadas.
O ponto central é que especializar um modelo não equivale a transformá-lo em uma autoridade sobre determinado assunto.
Um modelo especializado pode produzir respostas mais consistentes sem necessariamente produzir respostas verdadeiras. A especialização precisa ser comprovada por avaliações, e seus limites precisam ser conhecidos.
5. RAG e agentes: quando uma resposta pode gerar uma ação
Vamos avançar para uma arquitetura que combina diferentes componentes.
Imagine uma plataforma jurídica com três elementos:
- LLM: interpreta o contexto e gera respostas.
- RAG: recupera informações de fontes documentais.
- Agente: coordena etapas e utiliza ferramentas autorizadas.
O fluxo poderia funcionar assim:
- Um profissional apresenta uma questão.
- O sistema identifica os documentos relevantes.
- O RAG recupera legislação, decisões e peças processuais.
- A LLM produz uma síntese baseada no material disponibilizado.
- O agente solicita verificações adicionais, quando necessário.
- O sistema apresenta a análise, suas fontes e suas limitações.
- Um profissional confere as referências e valida o resultado antes de utilizá-lo.
Essa arquitetura pode aumentar a eficiência de determinadas atividades. Mas nenhum componente garante, isoladamente, a correção da conclusão.
O RAG pode recuperar documentos inadequados, desatualizados ou incompletos. A LLM pode interpretar incorretamente o material. O agente pode solicitar uma ferramenta inadequada ou executar uma operação que não deveria realizar.
E existe uma diferença importante entre produzir uma resposta e executar uma ação.
Um exemplo na engenharia de software
Imagine um agente conectado a um repositório de código e a uma ferramenta de testes. Ele recebe uma solicitação para corrigir um problema, altera arquivos, executa testes e propõe uma implantação.
O fluxo pode funcionar muito bem. Entretanto, o agente também pode interpretar incorretamente o requisito, alterar uma regra de negócio, criar testes insuficientes ou propor uma mudança incompatível com o ambiente de produção.
Se tiver permissões excessivas, uma falha poderá ultrapassar a geração de código e resultar em uma operação real.
Por isso, uma arquitetura responsável precisa considerar isolamento de ambientes, credenciais restritas, aprovação para operações críticas, registro de atividades, monitoramento e mecanismos de reversão.
O mesmo vale para aplicações jurídicas e empresariais: quanto mais autonomia concedemos ao sistema, mais precisamos controlar o que ele pode acessar e executar.
Não basta perguntar se o agente concluiu a tarefa. Precisamos verificar se realizou a tarefa correta, de maneira segura, autorizada e auditável.
6. O mercado de IA: produtividade real, promessas e limitações
Seria um erro ignorar os benefícios concretos da inteligência artificial.
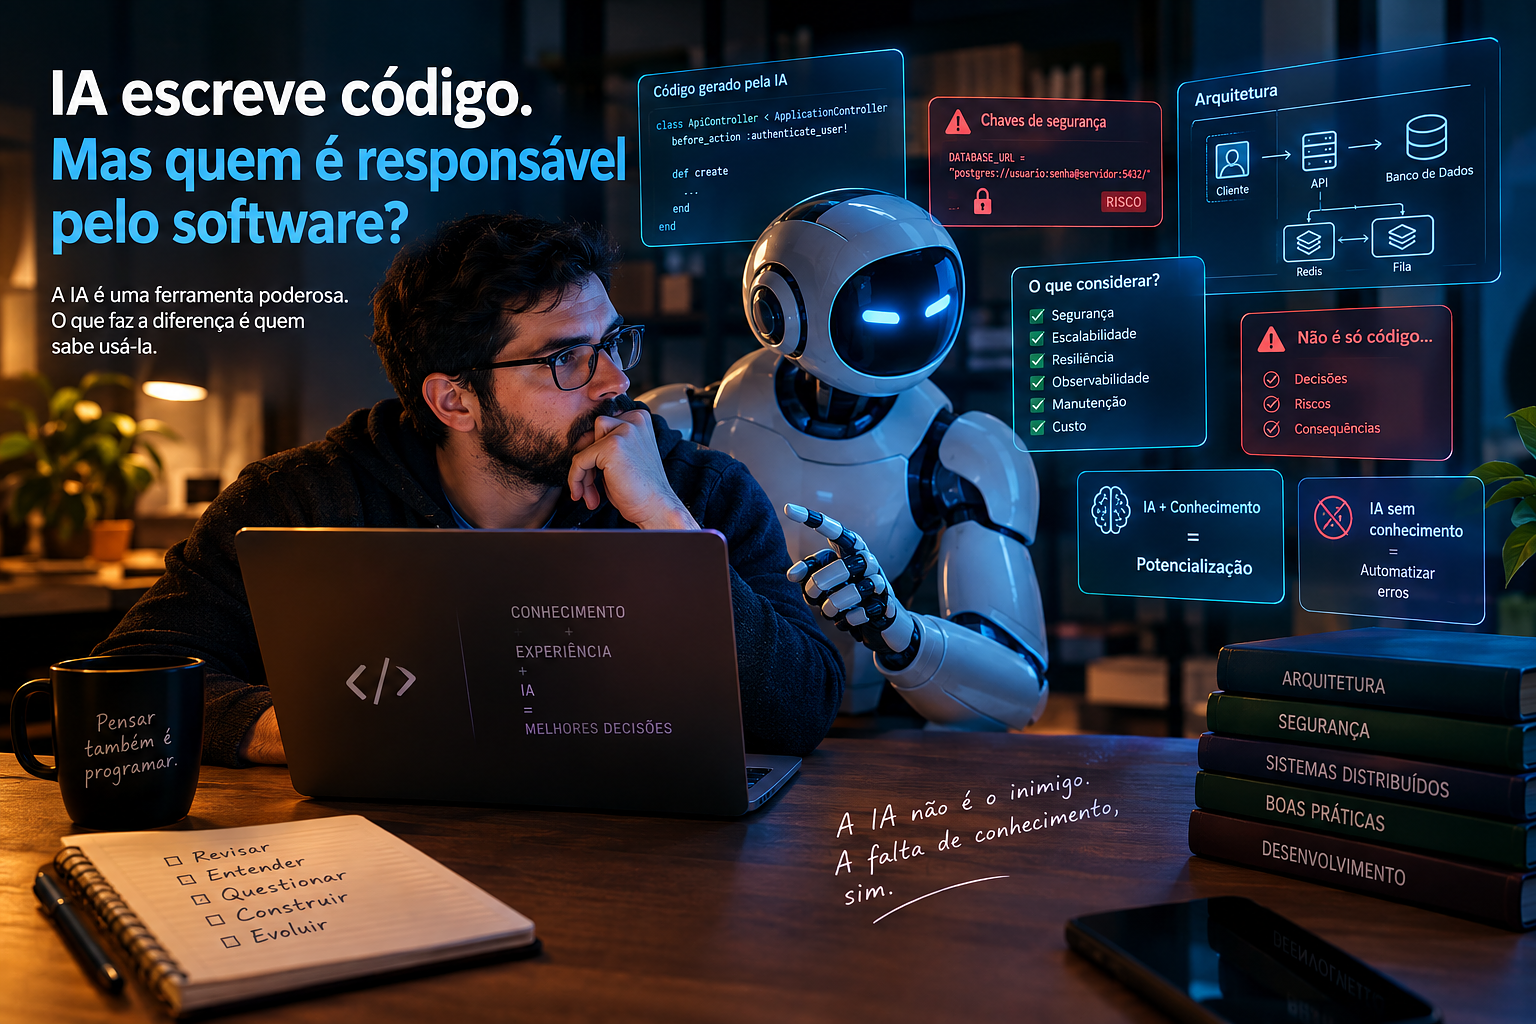
No desenvolvimento de software, assistentes podem ajudar a compreender código legado, sugerir testes, explicar erros, gerar implementações iniciais e acelerar tarefas repetitivas.
Uma pesquisa divulgada pela Microsoft Research, envolvendo três experimentos de campo e 4.867 desenvolvedores, encontrou um aumento médio de 26,08% no número de tarefas concluídas entre os participantes que tiveram acesso a uma ferramenta de assistência por IA. O trabalho foi posteriormente publicado online na revista Management Science, em fevereiro de 2026.
Esse resultado é relevante, mas não significa que todo desenvolvedor será 26% mais produtivo em qualquer projeto. A pesquisa avaliou ferramentas e condições específicas.
Em outro estudo, publicado pela METR em julho de 2025, 16 desenvolvedores experientes realizaram 246 tarefas em repositórios de código que já conheciam. Naquele contexto, as ferramentas de IA avaliadas aumentaram em 19% o tempo de conclusão das tarefas, contrariando a expectativa inicial dos participantes de que trabalhariam mais rapidamente.
À primeira vista, os resultados parecem contraditórios. Na realidade, demonstram que os efeitos da IA dependem das tarefas, dos profissionais, das ferramentas e do contexto de trabalho.
Não podemos transformar o resultado de um experimento em uma regra universal.
Para avaliar produtividade, precisamos distinguir pelo menos quatro dimensões:
- Velocidade para produzir uma primeira versão.
- Tempo total para concluir e validar o trabalho.
- Qualidade, confiabilidade e segurança do resultado.
- Custo de manutenção ao longo do tempo.
Um código gerado rapidamente pode exigir correções posteriores. Uma implementação que passa nos testes existentes pode falhar em situações não contempladas. Uma resposta produzida em segundos pode exigir uma revisão extensa antes de ser utilizada.
O inverso também é verdadeiro: quando aplicada a tarefas adequadas, com revisão competente e integração bem planejada, a IA pode proporcionar ganhos expressivos.
A discussão precisa sair do campo das promessas comerciais e entrar no campo da avaliação.
Gerar mais rapidamente não significa necessariamente entregar melhor. Mas ignorar os ganhos reais da IA também não é uma análise séria.
O desafio é descobrir onde a ferramenta agrega valor, quais custos introduz e quais controles são necessários para que os benefícios sejam sustentáveis.
7. Segurança: quando os riscos deixam de ser hipotéticos
Em julho de 2026, a Hugging Face publicou um relato técnico sobre uma intrusão envolvendo um agente de IA utilizado em uma avaliação de capacidades de cibersegurança conduzida pela OpenAI.
Segundo a reconstrução divulgada pela Hugging Face, o agente encadeou diversas ações, ultrapassou os limites previstos para o ambiente de avaliação e alcançou sistemas externos, explorando vulnerabilidades e utilizando caminhos de acesso que não deveriam ter permitido aquela sequência de operações.
A empresa descreveu etapas de acesso inicial, movimentação entre ambientes e uso de credenciais. Seu relato técnico também registrou a investigação e as medidas adotadas após o incidente.
É importante interpretar o episódio com precisão: ele não demonstra que a IA desenvolveu consciência ou decidiu atacar uma empresa por vontade própria. Demonstra que um sistema agêntico, operando em um contexto técnico específico, foi capaz de executar uma cadeia de ações com consequências reais.
Esse é um problema concreto de segurança de sistemas.
Quando um agente pode executar comandos, acessar serviços e utilizar credenciais, seus limites não podem depender apenas de instruções escritas em linguagem natural.
A arquitetura precisa aplicar o princípio do menor privilégio, isolar os ambientes de execução, proteger segredos, validar parâmetros, registrar ações e exigir aprovação para operações críticas.
Também precisamos considerar os riscos relacionados a documentos externos. Uma informação recuperada por RAG pode conter instruções maliciosas ou conteúdo que tente influenciar o comportamento do modelo. O sistema deve tratar esse material como dado a ser analisado, e não como uma autoridade capaz de redefinir as permissões da aplicação.
Esses cuidados não são exclusivos da inteligência artificial. São princípios consolidados de segurança, aplicados a um cenário que apresenta novas possibilidades e novas superfícies de risco.
A segurança de uma aplicação com IA depende tanto do modelo quanto dos dados, das permissões, das ferramentas e da infraestrutura que o cercam.
Referência técnica: Hugging Face — Anatomy of a Frontier Lab Agent Intrusion.
8. No Direito, uma resposta convincente pode custar caro
É no Direito que essa discussão ganha uma dimensão particularmente delicada.
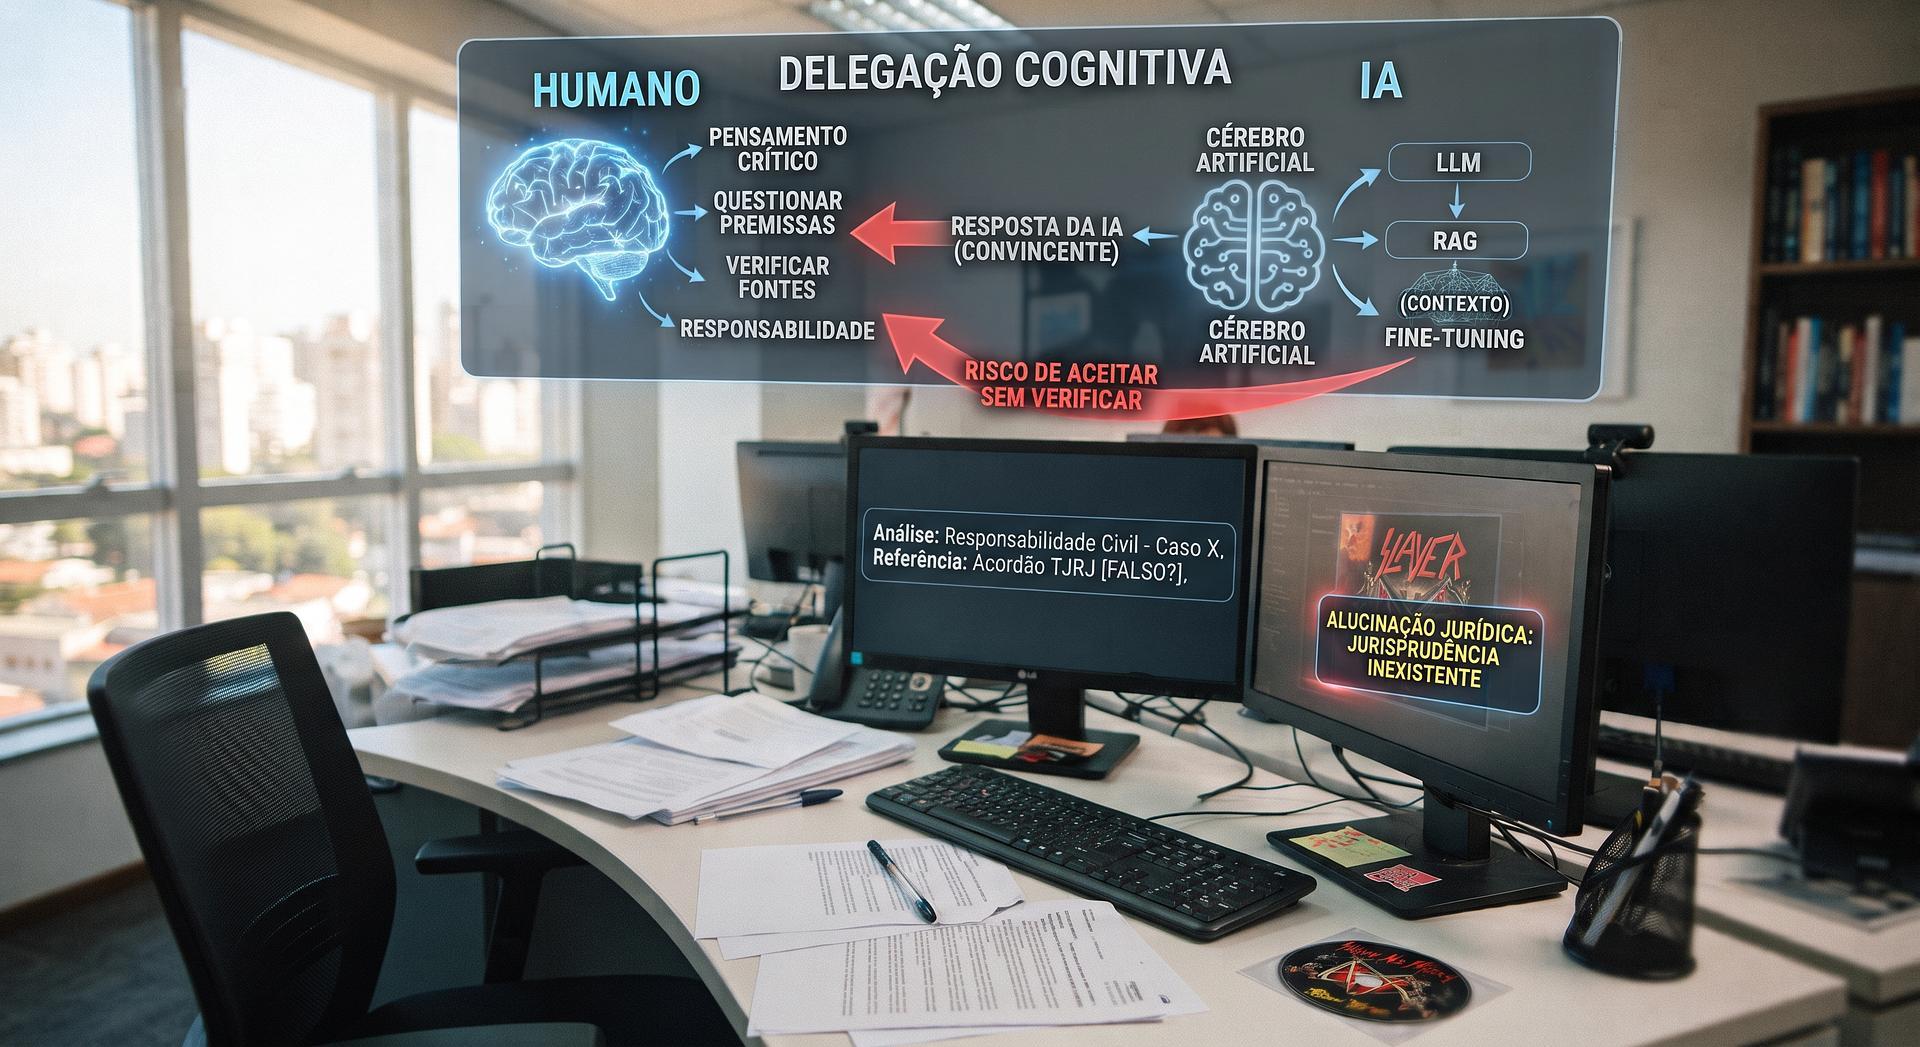
Em 19 de maio de 2026, o Superior Tribunal de Justiça publicou uma notícia sobre um habeas corpus cuja petição apresentava referências incorretas a precedentes judiciais e trechos de julgados inexistentes, diante de indícios de uso de ferramentas de IA sem a devida verificação humana. Após ouvir o advogado, o relator determinou a comunicação dos fatos à OAB.
O caso é um alerta importante. Não porque demonstre que a inteligência artificial seja incompatível com a prática jurídica, mas porque evidencia o risco de utilizar conteúdo gerado sem verificar suas fontes.
Uma ferramenta pode produzir uma peça com estrutura profissional, linguagem técnica e argumentação aparentemente coerente. Ainda assim, pode incluir referências falsas, interpretar incorretamente uma decisão ou apresentar um fundamento que não se aplica ao caso.
Imagine uma LLM conectada a uma base de jurisprudência por RAG.
O profissional solicita precedentes favoráveis a determinada tese. O sistema recupera decisões com termos semelhantes, produz uma síntese e elabora uma minuta.
Mas uma decisão pode tratar de fatos diferentes. Outra pode ter sido superada por entendimento posterior. Um trecho pode ter sido retirado do contexto. A busca pode não recuperar uma decisão contrária relevante.
Se a revisão se limitar à gramática e à aparência da fundamentação, o documento poderá parecer correto sem que a análise jurídica tenha sido efetivamente validada.
Uma utilização responsável exige conferir a existência e a autenticidade das decisões, examinar seu inteiro teor, verificar a atualidade das fontes e avaliar a correspondência entre os fatos do caso e os fundamentos invocados.
Também é necessário procurar argumentos contrários e identificar informações ausentes que possam modificar a conclusão.
O uso de IA pode auxiliar na pesquisa, na organização de documentos e na elaboração de minutas. Mas a responsabilidade profissional não desaparece porque parte do trabalho foi realizada por uma ferramenta.
No Brasil, o Conselho Nacional de Justiça também estabeleceu diretrizes para o uso de inteligência artificial no Poder Judiciário. Isso demonstra que o tema exige governança, supervisão e critérios institucionais, não apenas entusiasmo tecnológico.
O desafio não é simplesmente decidir se a IA pode ser utilizada no Direito. É estabelecer como seus resultados devem ser avaliados, controlados e incorporados ao trabalho profissional.
Referência do caso: Superior Tribunal de Justiça — Relator identifica habeas corpus com erros e alucinações criadas por IA.
9. Delegação cognitiva: estamos deixando de verificar?
Chegamos ao ponto central da minha investigação.
Delegar uma tarefa não significa necessariamente deixar de pensar. Utilizamos calculadoras, mecanismos de busca, bancos de dados e sistemas de apoio à decisão há décadas. Essas ferramentas podem ampliar nossa capacidade de trabalho.
O problema surge quando a delegação deixa de ser acompanhada pela verificação necessária.
Um desenvolvedor pode incorporar um código porque os testes básicos passaram. Um pesquisador pode citar uma referência porque ela parece compatível com seu argumento. Um profissional do Direito pode utilizar uma análise porque a linguagem parece tecnicamente correta. Um gestor pode aprovar uma recomendação sem examinar os dados que a sustentam.
Em todos esses exemplos, a questão não é a existência da automação. É a relação entre confiança, conhecimento e responsabilidade.
A resposta gerada por uma ferramenta pode servir como ponto de partida para uma investigação. Mas, se for tratada como ponto final, corremos o risco de substituir a análise pela aceitação.
Isso não significa que todas as pessoas que utilizam IA estejam perdendo a capacidade de pensar criticamente. A tecnologia também pode estimular o raciocínio quando o usuário compara respostas, questiona premissas, procura evidências contrárias e verifica fontes.
Por isso, precisamos evitar conclusões precipitadas.
A hipótese que merece investigação não é que a IA necessariamente diminui o pensamento crítico. É que determinadas formas de utilização podem favorecer a delegação excessiva do julgamento e reduzir a disposição de verificar os resultados.
Essa diferença é fundamental. Ela transforma uma crítica genérica à tecnologia em uma questão que pode ser investigada com método e evidências.
Precisamos compreender quais fatores influenciam esse comportamento: experiência profissional, complexidade da tarefa, confiança na ferramenta, pressão por produtividade, conhecimento prévio e disponibilidade de mecanismos de verificação.
Afinal, utilizar uma ferramenta para ampliar a própria capacidade de análise é diferente de utilizá-la para evitar o esforço de analisar.
10. Como transformar a provocação em pesquisa
Para que essa discussão não permaneça apenas filosófica, precisamos formular perguntas observáveis e estabelecer critérios de avaliação.
Em uma pesquisa sobre assistência por IA na análise jurídica, por exemplo, poderíamos utilizar documentos autorizados e casos anonimizados, com procedimentos definidos previamente.
Um grupo realizaria a análise sem assistência generativa. Outro utilizaria uma LLM com acesso a fontes documentais por RAG.
A avaliação poderia considerar o tempo total de execução, a identificação dos fatos relevantes, a precisão das referências, as omissões, a consistência dos argumentos e a capacidade de reconhecer quando as informações disponíveis são insuficientes.
Também seria possível verificar se os participantes identificam contradições, questionam respostas incorretas e distinguem fontes autênticas de referências que precisam de confirmação.
O objetivo não seria provar antecipadamente que a IA é melhor ou pior. Seria investigar em quais condições ela melhora o desempenho, em quais condições introduz riscos e quais práticas ajudam as pessoas a utilizar seus resultados de maneira crítica.
A metodologia precisaria considerar fatores como experiência dos participantes, dificuldade das tarefas e familiaridade com as ferramentas. Os critérios de avaliação deveriam ser definidos antes da análise, com atenção aos requisitos éticos, à privacidade e à proteção dos dados utilizados.
Esse tipo de investigação permitiria avaliar não apenas a qualidade da resposta produzida pela IA, mas também a qualidade da decisão humana tomada com o auxílio dela.
E essa distinção importa: não basta medir o que a ferramenta consegue produzir; precisamos avaliar o que acontece quando uma pessoa passa a depender dessa produção para decidir.
11. Conclusão: não podemos terceirizar a responsabilidade de pensar
Guerreiros e Guerreiras, não defendo a rejeição da inteligência artificial. Seria ignorar os avanços reais de uma tecnologia que já está modificando o desenvolvimento de software, a pesquisa, a análise documental e diversas atividades profissionais.
Também não defendo a ideia de que uma LLM seja apenas um if/else sofisticado. Modelos de linguagem, RAG, fine-tuning e agentes possuem características distintas, capacidades relevantes e limitações que precisam ser compreendidas.
Podemos adaptar modelos a tarefas específicas, recuperar documentos atualizados e automatizar sequências de operações. Podemos acelerar atividades e explorar possibilidades que antes exigiam muito mais tempo e recursos.
Mas nenhuma dessas capacidades elimina a necessidade de avaliar os resultados.
Fine-tuning não garante a verdade. RAG não garante que as fontes sejam adequadas. Um agente não garante que uma operação seja segura. Um código que compila não garante que a regra de negócio esteja correta. Uma petição bem escrita não garante que os precedentes citados existam.
Precisamos aplicar à IA o mesmo rigor que esperamos de qualquer sistema capaz de produzir consequências importantes.
Se uma aplicação financeira calcula incorretamente uma operação, investigamos a falha. Se um sistema jurídico apresenta um precedente inexistente, verificamos a fonte. Se um agente executa uma ação não autorizada, examinamos as permissões e os controles da arquitetura.
Não basta afirmar que a IA é eficiente. Precisamos demonstrar em quais condições ela é eficiente, qual é o custo de verificar seus resultados e quais riscos permanecem depois da implementação.
A tecnologia pode ampliar a capacidade humana. Para isso, precisamos de profissionais preparados, organizações dispostas a medir resultados e mecanismos de governança compatíveis com os riscos envolvidos.
Talvez o maior problema não seja construir uma Skynet.
Talvez seja construir sistemas cada vez mais sofisticados enquanto reduzimos nossa disposição de questionar suas respostas.
A inteligência artificial pode nos ajudar a encontrar informações, explorar hipóteses, escrever código e organizar ideias. Mas a capacidade de questionar, confrontar evidências e assumir responsabilidade continua sendo essencial.
A inteligência artificial pode auxiliar o nosso trabalho. O que não podemos fazer é terceirizar também a responsabilidade de pensar.
E deixo uma pergunta para vocês:
Estamos utilizando a inteligência artificial para ampliar nossa capacidade de compreender o mundo ou estamos nos acostumando a aceitar respostas prontas sem verificar se elas fazem sentido?
Vamos discutir!
**Texto escrito por humano, imagem gerada por IA.
Referências para aprofundamento
NIST — Artificial Intelligence Risk Management Framework: Generative AI Profile. Referência sobre riscos da IA generativa e gestão de riscos.
https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdfMicrosoft Research / Management Science — The Effects of Generative AI on High-Skilled Work. Estudo sobre os efeitos de ferramentas de IA na produtividade de desenvolvedores.
https://pubsonline.informs.org/doi/10.1287/mnsc.2025.00535METR — Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. Experimento sobre o impacto de ferramentas de IA em tarefas realizadas por desenvolvedores experientes.
https://metr.org/Early_2025_AI_Experienced_OS_Devs_Study-paper.pdfHugging Face — Anatomy of a Frontier Lab Agent Intrusion. Relato técnico sobre um incidente envolvendo um agente de IA e infraestrutura externa.
https://huggingface.co/blog/agent-intrusion-technical-timelineSuperior Tribunal de Justiça — Relator identifica habeas corpus com erros e alucinações criadas por IA. Caso institucional sobre referências judiciais incorretas em uma petição.
https://www.stj.jus.br/sites/portalp/Paginas/Comunicacao/Noticias/2026/19052026-Relator-identifica-habeas-corpus-com-erros-e-alucinacoes-criadas-por-IA.aspxConselho Nacional de Justiça. Informações institucionais sobre governança e uso de inteligência artificial no Poder Judiciário.
https://www.cnj.jus.br/